CostBench
Compare model quality, task success, recorded resources, and measured cost on the same tasks.
Frozen v2 research · 30 tasks · 11 task templates · 5 repeats · evidence dated 2026-10-03
These results describe the tested configurations and do not predict performance on other tasks or setups.
Results
Each row identifies its model, harness, task environments, and execution policies. All 450 selected attempts remain in the primary v2 outcome denominator. Cost includes only measured resource categories with declared prices.
- Tasks
- 30
- Task families
- 3
- Repeats per task
- 5
- Selected attempts
- 450
- Successful attempts
- 418
- Success threshold
- 1 utility
- Price vector
- costbench-published-2026-10-02-v1
- Price date
- 2026-10-02
- Source digest
- 98e6afe2787a8e49…
| Configuration | Mean utility | Successes | Measured cost / success | Median cost / attempt | Productive efficiency | Resources |
|---|---|---|---|---|---|---|
gpt-4.1Configuration and diagnostics{
"budget": {
"api": "4000000",
"database": "4000000",
"swe": "4000000"
},
"context_policy": {
"api": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"database": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"swe": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
}
},
"family_identities": [
{
"family_fingerprint": "43bffbe9df5d7633ad2b28e3467181e5f017ac037ad725b493acdc71bc1700f9",
"family_id": "swe"
},
{
"family_fingerprint": "a9e63bf6184cd2520d12914d597379dc0f41fe2690826ba0794bafd6a4dcc3e2",
"family_id": "database"
},
{
"family_fingerprint": "af69046030487bcf35d839e588e2dc2139d68a28a962b6e4af3ce7dd3acde084",
"family_id": "api"
}
],
"harness": "EvalRouter native CostBench harness",
"harness_sha": "af256398943f1fec22a71d71281f663b96cdefdf476bacb9a19a09c3bbf4ca58",
"harness_version": "evalrouter.costbench.v1",
"model": "openai/gpt-4.1-2025-04-14@tools-v1",
"model_version": "gpt-4.1-2025-04-14",
"prompt_policy_version": {
"api": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"database": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"swe": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589"
},
"provider": "openai",
"retry_policy": {
"api": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"database": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"swe": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
}
},
"runtime_image_digest": "95ccacbb4392a49eceef65847c9fad1da1deb53af8312ab374e8dcec79806058",
"sampling": {
"api": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"database": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"swe": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
}
},
"tools": {
"api": "c68320cd966e65301f52d4d733753514c4226299b8c9476435d8d6ba9c2a5a1e",
"database": "6ba7541dab8ed4849e916dabc55bfd4a1c31c27363df914483e56df3b1d878d5",
"swe": "d8478ab47ed68e3c95da6d4c51552b641bd47628737df5c084c5d842723d2f49"
}
}Elapsed time: median 18.886 seconds; 150 known observations and 0 unknown. Failure classes: none recorded. Unsuccessful attempt spend heuristic: 0.06264166871645653. This is descriptive and not a causal savings estimate. | 0.99 (0.974 to 1) | 146/150 (97.3%) | USD 0.00548075 | USD 0.002643291 | 1 | Recorded quantitiescached input tokens: 6,656 cpu core nanosecs: 3,442,030,396,078 gpu nanosecs: 0 input tokens: 220,994 mem gib nanosecs: 6,884,060,792,308 output tokens: 21,659 reasoning output tokens: 0 total output tokens: 0 Price vector: costbench-gpt-4.1-published-2026-10-02-v1 Unpriced: none |
gpt-4.1-miniConfiguration and diagnostics{
"budget": {
"api": "4000000",
"database": "4000000",
"swe": "4000000"
},
"context_policy": {
"api": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"database": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"swe": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
}
},
"family_identities": [
{
"family_fingerprint": "58cd1eb775d32cb0b94c5ad32c5c10a6edbb93a69c5721654ec07bad4c0be3a4",
"family_id": "swe"
},
{
"family_fingerprint": "3843ddfe8ca1daeda0740cb4329bf22499d2783d7f681ac57cd12bba2c8df59e",
"family_id": "database"
},
{
"family_fingerprint": "a8778c6846a287eab57241532f8be89fb23b576aa945c88f10ba09bf2870491b",
"family_id": "api"
}
],
"harness": "EvalRouter native CostBench harness",
"harness_sha": "af256398943f1fec22a71d71281f663b96cdefdf476bacb9a19a09c3bbf4ca58",
"harness_version": "evalrouter.costbench.v1",
"model": "openai/gpt-4.1-mini-2025-04-14@tools-v1",
"model_version": "gpt-4.1-mini-2025-04-14",
"prompt_policy_version": {
"api": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"database": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"swe": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589"
},
"provider": "openai",
"retry_policy": {
"api": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"database": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"swe": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
}
},
"runtime_image_digest": "95ccacbb4392a49eceef65847c9fad1da1deb53af8312ab374e8dcec79806058",
"sampling": {
"api": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"database": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"swe": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
}
},
"tools": {
"api": "c68320cd966e65301f52d4d733753514c4226299b8c9476435d8d6ba9c2a5a1e",
"database": "6ba7541dab8ed4849e916dabc55bfd4a1c31c27363df914483e56df3b1d878d5",
"swe": "d8478ab47ed68e3c95da6d4c51552b641bd47628737df5c084c5d842723d2f49"
}
}Elapsed time: median 22.977 seconds; 150 known observations and 0 unknown. Failure classes: none recorded. Unsuccessful attempt spend heuristic: 0.057791911890224285. This is descriptive and not a causal savings estimate. | 0.908 (0.746 to 1) | 132/150 (88%) | USD 0.002302645 | USD 0.001553757 | 1 | Recorded quantitiescached input tokens: 2,304 cpu core nanosecs: 3,370,848,183,020 gpu nanosecs: 0 input tokens: 207,774 mem gib nanosecs: 6,741,696,366,174 output tokens: 26,727 reasoning output tokens: 0 total output tokens: 0 Price vector: costbench-gpt-4.1-mini-published-2026-10-02-v1 Unpriced: none |
claude-haiku-4.5Configuration and diagnostics{
"budget": {
"api": "4000000",
"database": "4000000",
"swe": "4000000"
},
"context_policy": {
"api": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"database": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
},
"swe": {
"max_output_tokens": 2048,
"resource_limits": {
"cpu_millis": 1000,
"duration_seconds": 300,
"max_observation_bytes": 32768,
"max_output_tokens": 2048,
"max_steps": 20,
"memory_mib": 2048,
"network": "blocked"
}
}
},
"family_identities": [
{
"family_fingerprint": "dc5c90e65ffd532093f4fc784e5c26ec963852b6378b89b04b31916666c320dc",
"family_id": "swe"
},
{
"family_fingerprint": "0e71f9f89c814f20f3aa10c76f0f2603a9b74c1835a57ee2b1eec813943e2f13",
"family_id": "database"
},
{
"family_fingerprint": "afbf31ab60919f6ac5fa450cc5356444b859073942441d646e34d06cddc7e264",
"family_id": "api"
}
],
"harness": "EvalRouter native CostBench harness",
"harness_sha": "af256398943f1fec22a71d71281f663b96cdefdf476bacb9a19a09c3bbf4ca58",
"harness_version": "evalrouter.costbench.v1",
"model": "anthropic/claude-haiku-4-5-20251001@tools-v1",
"model_version": "claude-haiku-4-5-20251001",
"prompt_policy_version": {
"api": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"database": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589",
"swe": "86bcae8d0033b937135602b41cebb826ad11fa4a29c203081f6d2e45d570b589"
},
"provider": "anthropic",
"retry_policy": {
"api": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"database": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
},
"swe": {
"policy_version": "gateway-generation-retry-v1",
"provider_generation_attempts": 3,
"target_output_mode": null,
"target_output_mode_attempts": 1,
"tool_operation_recovery": "receipt-only"
}
},
"runtime_image_digest": "95ccacbb4392a49eceef65847c9fad1da1deb53af8312ab374e8dcec79806058",
"sampling": {
"api": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"database": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
},
"swe": {
"generation": null,
"provider_seed": null,
"seed_policy": "not-requested-by-gateway-v1",
"temperature": 0
}
},
"tools": {
"api": "c68320cd966e65301f52d4d733753514c4226299b8c9476435d8d6ba9c2a5a1e",
"database": "6ba7541dab8ed4849e916dabc55bfd4a1c31c27363df914483e56df3b1d878d5",
"swe": "d8478ab47ed68e3c95da6d4c51552b641bd47628737df5c084c5d842723d2f49"
}
}Elapsed time: median 31.072 seconds; 150 known observations and 0 unknown. Failure classes: benchmark_infrastructure_failure 8, execution 2. Unsuccessful attempt spend heuristic: 0.08130427995163376. This is descriptive and not a causal savings estimate. | 0.933 (0.813 to 1) | 140/150 (93.3%) | USD 0.01034214 | USD 0.00748529 | 0.5526554 | Recorded quantitiescached input tokens: 0 cpu core nanosecs: 4,780,035,671,819 gpu nanosecs: 0 input tokens: 789,205 mem gib nanosecs: 9,560,071,343,764 total output tokens: 81,300 Price vector: costbench-claude-haiku-4.5-published-2026-10-02-v1 Unpriced: none |
Observed frontier: gpt-4.1, gpt-4.1-mini. Confidence intervals are descriptive paired task-template bootstrap intervals.
Paired system comparisons
Descriptive paired cluster intervals, unadjusted for multiple comparisons. An interval containing zero does not establish equivalence.
- gpt-4.1 versus gpt-4.1-mini: difference observed. cost per success difference -0.007 to -0.001. quality difference -0.231 to 0. success rate difference -0.237 to 0.
- gpt-4.1 versus claude-haiku-4.5: difference observed. cost per success difference 0.003 to 0.007. quality difference -0.181 to 0.017. success rate difference -0.179 to 0.041.
- gpt-4.1-mini versus claude-haiku-4.5: difference observed. cost per success difference 0.004 to 0.012. quality difference -0.15 to 0.226. success rate difference -0.125 to 0.257.
Results by task family
Family results separate software engineering, database operations, and API and state tasks. Select a system and task to inspect individual repeats, resource quantities, costs, and receipt provenance.
| System | Success | Median utility | Measured cost / attempt | Measured cost / success | Expected time / success |
|---|---|---|---|---|---|
| 94% (47/50) | 1 | USD 0.006306795 | USD 0.0110184 | 38.96 s | |
| 90% (45/50) | 1 | USD 0.002731151 | USD 0.003040418 | 33.439 s | |
| 80% (40/50) | 1 | USD 0.01353817 | USD 0.02063385 | 115.432 s |
3 task-template clusters. Family-level confidence intervals are not estimated because three or four clusters are too few for stable inference.
Inspect task attempts
| Repeat | Status | Utility | Duration | Operations | Measured cost | Details | ||||||||||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | completed | 1 | 23.253 s | Model 2, tool 1, retry 0 | USD 0.003310276 | Resources and evidence
Known priced subtotal: USD 0.003310276. Complete measured cost: USD 0.003310276. Run e92e3159-fb09-44ce-ad96-e932eb1e0d22; observation 4ef37f08-ef06-58b9-8e8a-b3f3ccab80c5. Source digest 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Report checksum 60fea2db37f82e95532897d074b01c6301052c485c921d9006933b26194bf27b. Receipt IDs: inference:217d2350-e958-458e-bd1a-ce6ee778d298, inference:c9b2bcbd-2316-4ed2-b201-2fd3ac4fff04, resource_receipt:1899, resource_receipt:1900. | ||||||||||||||||||||||||
| 2 | completed | 1 | 16.851 s | Model 2, tool 1, retry 0 | USD 0.003250068 | Resources and evidence
Known priced subtotal: USD 0.003250068. Complete measured cost: USD 0.003250068. Run 0f6281cb-77b3-4d8c-90f8-c4f97346a9bb; observation 9203913c-b952-5142-85b1-acfebe7d0f95. Source digest 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Report checksum 89601ef7022b7710dbb60c057b7a5ad5b1a787c48ac2a522356a4bf66b80307a. Receipt IDs: inference:4547caf7-d10d-4086-b39d-425f2ba9c769, inference:d28952a5-ebca-49f8-903b-944cc6b4a635, resource_receipt:1887, resource_receipt:1888. | ||||||||||||||||||||||||
| 3 | completed | 1 | 18.655 s | Model 2, tool 1, retry 0 | USD 0.00335565 | Resources and evidence
Known priced subtotal: USD 0.00335565. Complete measured cost: USD 0.00335565. Run c53da158-1722-42b8-aa33-c53401c851af; observation dd459e01-b27f-56f4-a84d-965247d793e7. Source digest 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Report checksum c1265d01efbecc0ec30808ca01b642f23844ad5fc4febe2928716e89db6c34d5. Receipt IDs: inference:82e52948-09d4-425e-a8f2-99862d40631b, inference:b6ae528f-eda9-49c1-ae82-a058cb8207e0, resource_receipt:1878, resource_receipt:1879. | ||||||||||||||||||||||||
| 4 | completed | 1 | 16.839 s | Model 2, tool 1, retry 0 | USD 0.003250133 | Resources and evidence
Known priced subtotal: USD 0.003250133. Complete measured cost: USD 0.003250133. Run da41325e-9af2-48f6-bbbb-61ecd6e65cb8; observation 165b26e2-4398-51f8-bace-866b0eed97ad. Source digest 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Report checksum b700d68716795ed76db12dd9916a077206b479d06a75ab0cb780df7ce9e5010d. Receipt IDs: inference:3e82a25d-fb49-4378-8636-0417ae333475, inference:ec7222f5-cdd6-4170-a75a-c16f33a19fed, resource_receipt:2015, resource_receipt:2016. | ||||||||||||||||||||||||
| 5 | completed | 1 | 19.471 s | Model 2, tool 1, retry 0 | USD 0.002993684 | Resources and evidence
Known priced subtotal: USD 0.002993684. Complete measured cost: USD 0.002993684. Run f2560dfa-b707-40d8-8f91-16deafa6d385; observation 8c25f751-1a9a-53a2-b2ab-f66a2ba1d243. Source digest 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Report checksum 88658cdc9bb2677e7e54e400d054778286e108b74b3408b1fc918be02c4b2f89. Receipt IDs: inference:41ff7bc6-c426-49c0-a80c-c045d8eac37c, inference:e510d149-bde2-4eee-845b-99ca74428f5e, resource_receipt:2006, resource_receipt:2007. |
Incomplete or unpriced categories remain unknown. Unsuccessful-attempt spend is descriptive and does not estimate causal savings. Task outputs and grader answers are not published.
Measured cost and quality charts
The figures are generated from the source-bound v2 release. Their axes, price basis, and provenance accompany each chart.
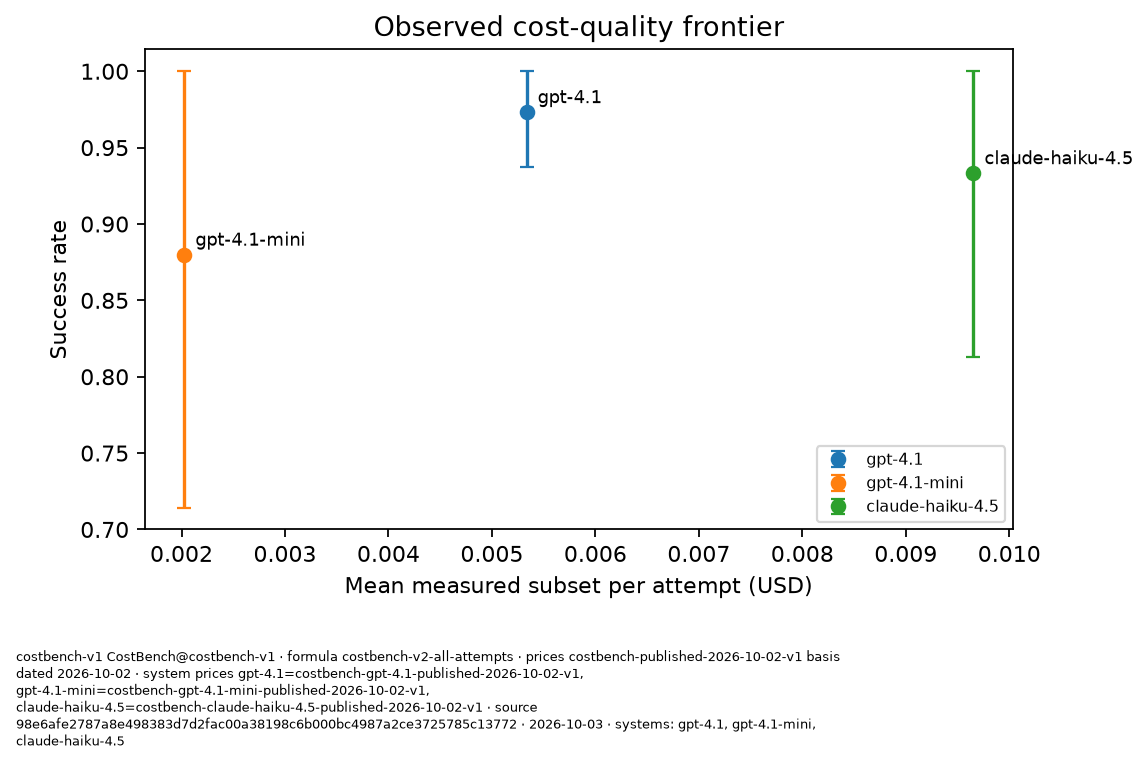
Chart provenance
costbench-v1 CostBench@costbench-v1 · formula costbench-v2-all-attempts · prices costbench-published-2026-10-02-v1 basis dated 2026-10-02 · system prices gpt-4.1=costbench-gpt-4.1-published-2026-10-02-v1, gpt-4.1-mini=costbench-gpt-4.1-mini-published-2026-10-02-v1, claude-haiku-4.5=costbench-claude-haiku-4.5-published-2026-10-02-v1 · source 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772 · 2026-10-03 · systems: gpt-4.1, gpt-4.1-mini, claude-haiku-4.5
Resource costs and evidence
Measured resource costs are calculated from recorded quantities and the dated price vectors. Missing quantities and unpriced resources remain unknown. Inference estimates and test-ledger debits are separate from measured resource costs.
Shared resource prices
cpu core nanosecsUSD 3.942E-14 per nanosecond
mem gib nanosecsUSD 6.67E-15 per nanosecond
costbench-published-2026-10-02-v1, effective 2026-10-02.
Source integrity
Source SHA-256: 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772
45 immutable report versions contributed to this projection. Download the source evidence to inspect sanitized receipts and checksums.
Task outputs and grader answers are not published.
Downloads
Each file is served from the verified v2 release. The reproduction bundle includes its own manifest and checksum.
Release source SHA-256: 98e6afe2787a8e498383d7d2fac00a38198c6b000bc4987a2ce3725785c13772. Results are limited to the tested model and harness configurations, task cohort, resource meters, and price vectors.